심혈관 영상에서 딥러닝의 과제와 전략: 박출계수와 심부전 관리
Pasdeloup et al.
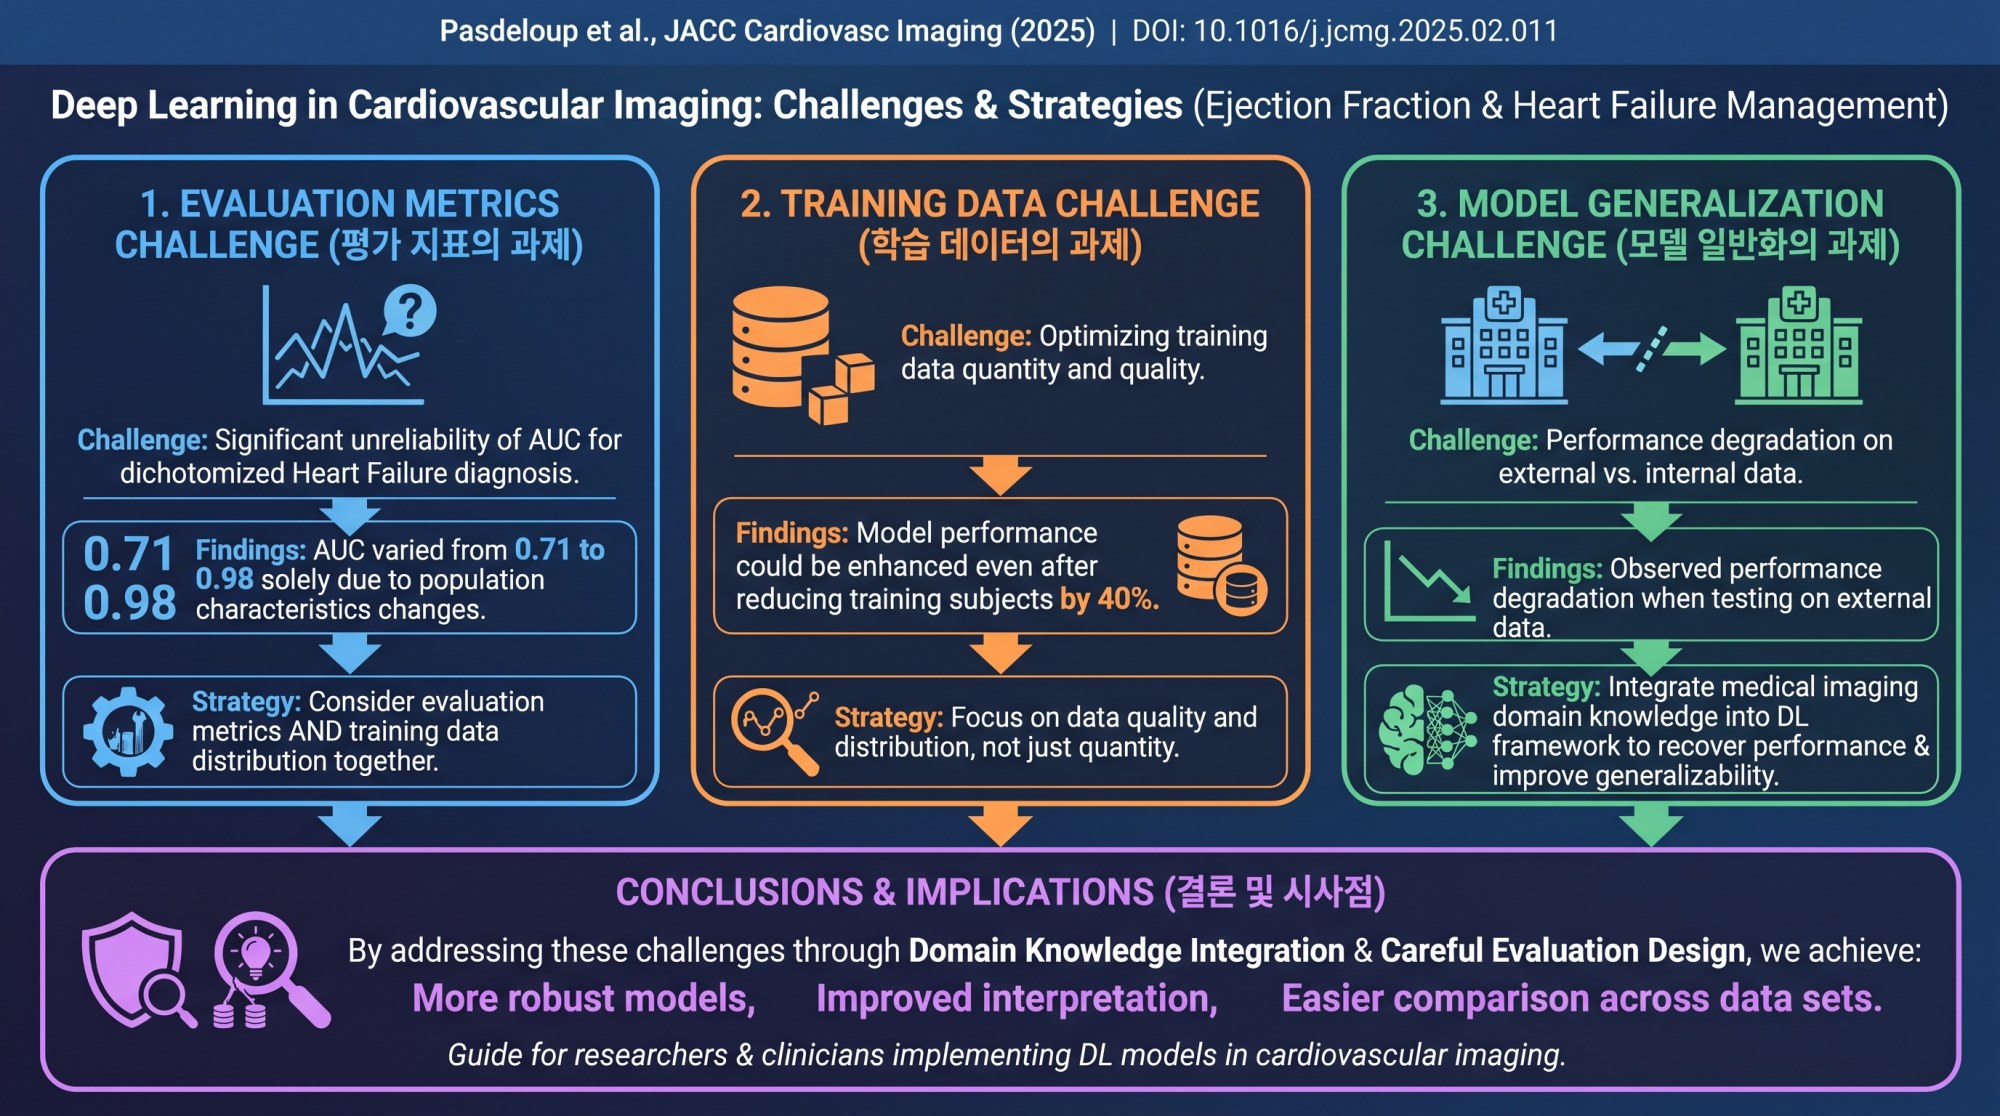 - AUC 0.71~0.98 범위의 극심한 변동성은 이분화된 심부전 진단 평가에서 메트릭 선택이 얼마나 위험한지 보여주며, 임상 도입 전 성능 검증 방식의 근본적 재검토가 필요합니다.
- 외부 데이터셋에서의 성능 저하 문제를 영상의학 도메인 지식 통합으로 부분 해결했으나, 실제 임상 환경의 다양한 획득 프로토콜과 기계 간 차이에 대한 견고성은 여전히 미충분합니다.
- 훈련 데이터 40% 감소에도 성능 유지 가능하다는 발견은 주목할 만하지만, 이미 충분히 큰 3,538명 대규모 데이터셋 내에서의 결과이므로 소규모 센터의 실무 적용성은 별개의 문제입니다.
본 연구는 2025 PRIME 2.0 체크리스트가 강조하는 심혈관 영상 특유의 평가 문제와 모델 일반화 전략을 다루며, 2024 CLAIM 지침의 외부 검증 보고와 실패 분석 권고를 충족하는 실증적 근거를 제공합니다.
근거 2025 PRIME 2.0 심혈관 영상 멀티모달 AI 평가 체크리스트 · CLAIM 2024 의료영상 AI 체크리스트
앞으로 필요한 연구 자동화된 LVEF 측정이 임상 결과 예측과 심부전 예후에 미치는 영향을 평가하는 전향적 다기관 연구가 필요합니다.
일차적 의견
• 3개의 별도 인구집단(N=3,538)에서 감독식 딥러닝을 이용한 자동화된 LVEF 측정을 심부전 관리를 위해 평가.
• AUC는 인구 특성만으로도 0.71–0.98 범위로 불안정하게 변함; 훈련 데이터 40% 감소에도 모델 성능 유지; 영상 도메인 지식 통합으로 외부 검증 성능 저하 회복 가능.
• 임상 결과 예측 평가 제한적; LVEF 단일 지표에 의존.
영상 도메인 지식 통합과 평가 지표의 신중한 선택은 서로 다른 인구에서 자동화된 LVEF 측정의 딥러닝 일반화를 크게 향상시켜 임상적 적용의 안전성을 높인다.
쉽게 풀어 쓴 해설
심장 초음파에서 중요한 수치를 측정할 때 인공지능을 쓰는 경우가 늘고 있어요. 연구실에서는 잘 작동하지만 실제 진료에 쓸 때도 똑같이 정확한지가 문제예요. 이 연구는 심부전 환자의 심장 짜내는 힘(박출률)을 측정할 때 인공지능이 맞닥뜨리는 세 가지 문제를 찾았어요.
연구팀은 3천 5백 명을 넘는 환자 세 그룹에서 인공지능으로 박출률을 자동 측정했습니다. 성공도를 판단하는 평가 지표(AUC)를 보니 문제가 보였어요. 환자 집단의 특성만 달라져도 0.71에서 0.98까지 큰 폭으로 변했거든요.
평가 지표가 환자 그룹에 따라 판판이 달라진다는 뜻이에요. 인공지능의 성능이 나빠진 게 아니라 평가 방법 자체가 믿을 수 없다는 뜻입니다. 이렇게 되면 인공지능이 정말 잘 작동하는지 판단하기가 어려워요.
훈련에 쓰는 환자 데이터의 양을 40% 줄였는데도 성능이 오히려 나아질 수 있었어요. 데이터 양보다 얼마나 다양한 환자를 포함하느냐가 더 중요하다는 뜻이에요.
한 병원 데이터로 훈련한 인공지능을 다른 병원에서 쓸 때 성능이 떨어지는 문제도 있었어요. 하지만 초음파 검사의 의학 지식을 인공지능 설계에 담으면 다른 병원에서의 성능도 크게 회복되었습니다. 의료 전문 지식을 반영하는 것이 핵심이었어요.
이 연구는 인공지능이 실제 진료에 도입되려면 세 가지를 다 개선해야 한다고 말해요. 평가 방법이 더 믿을 만하고, 훈련 방식이 더 똑똑해야 하며, 여러 병원에서 쓸 수 있어야 한다는 뜻이에요.
본인의 심초음파 결과를 인공지능이 측정했다면, 그 수치를 담당 의사가 직접 본 초음파 영상과 어떻게 맞춰서 판단했는지 물어보는 게 좋아요.